用上DevOps平台了,怎么判断用得好不好?
原创- 陈哥聊测试🌻
 2026-10-29 15:54:03
 39
本篇目录
大家好,我是陈哥。
我前段时间拜访客户,有个客户问我:陈哥,我们团队已经用上禅道DevOps平台,流程也算是跑通了,但是怎么来断定到底用得好不好?
我说,DORA指标正好可以解决你这个疑问。
在DORA指标立,前三项衡量了吞吐量,也就是团队工作的完成速度;后两项衡量了稳定性,嗲表了交付的安全性。真正高效的团队,不会单纯为了追求某一项指标,而牺牲另一项。
1. 部署频率
部署频率衡量的是你们团队向生产环境发布代码的频率。实际上,这反映了团队是否能做到小批量上线和高自动化。部署过程越繁琐,团队就越不敢频繁发版,反之亦然。
给大家一个可以参考的基准数:
变更提前期(也称变更交付周期 )衡量的是已提交的代码到达生产环境所需的时间。这一般与写代码的速度没什么关系,它主要取决于工作在队列中的等待时间,例如pull请求审查或质量保证交接。如果交付周期过长,那就是流程上出现了问题,而不是工作量问题。
给大家一个可以参考的基准数:
部署失败恢复时间衡量的是团队在因代码更改导致部署失败后恢复服务的速度。这比通用的平均恢复时间(MTTR)更有用,因为它能隔离我们自身引入的故障。它能更清晰地表明我们的交付系统应对变化的弹性。
变更失败率衡量的是部署过程中出现故障,需要立即进行补救(例如回滚或热修复)的占比。
这个指标只有在特定背景下才有意义。如果故障率和部署频率比较低,不一定是质量有多好,可能是在规避风险。健康的交付,是要吞吐量和稳定性两手抓。
给大家一个可以参考的基准数:
部署返工率衡量的是计划外部署和由生产事故触发的部署的占比。高返工率意味着团队耗费资源修复问题,这是系统性质量或工作流程问题的早期预警信号。
因为部署返工率是新增度量项,目前还没有官方行业基准。
但DORA指标也有局限,就是它只能告诉我们发生了什么,不能告诉我们为什么会发生。举个例子,如果交付周期边长,原因可能是代码审查缓慢,也可能是质量问题,具体原因我们没办法通过指标看出来的。
所以,我们要思考的问题从来都不是DORA指标有没有变得更好,而是:
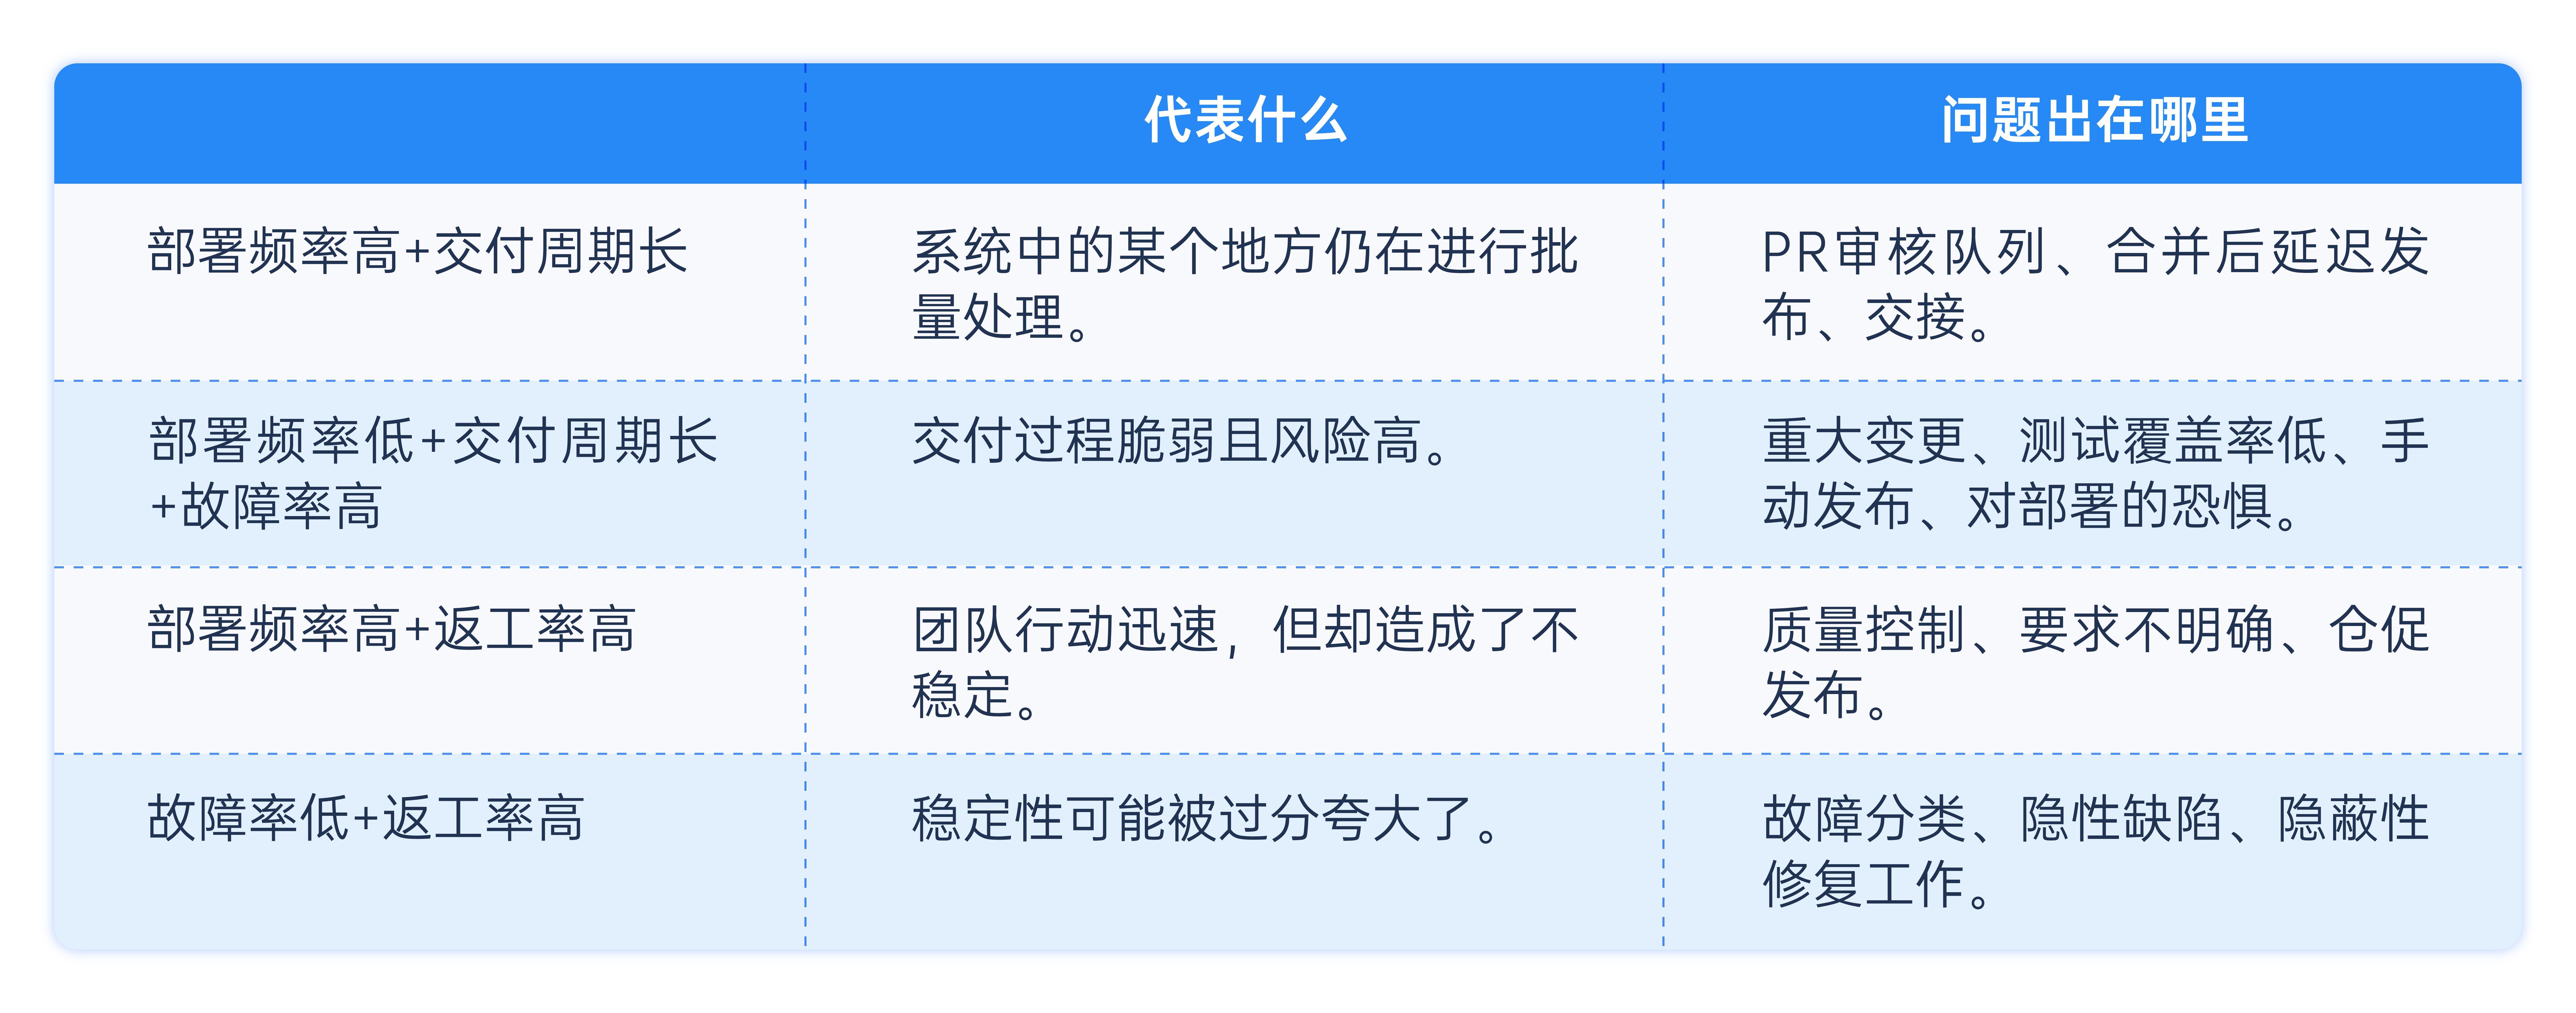
借助禅道DevOps平台,我们可以统计分析出DORA指标,看清团队交付的吞吐量与稳定性。但数据只是表象,不能孤立看待数字高低,更要结合指标组合模式。
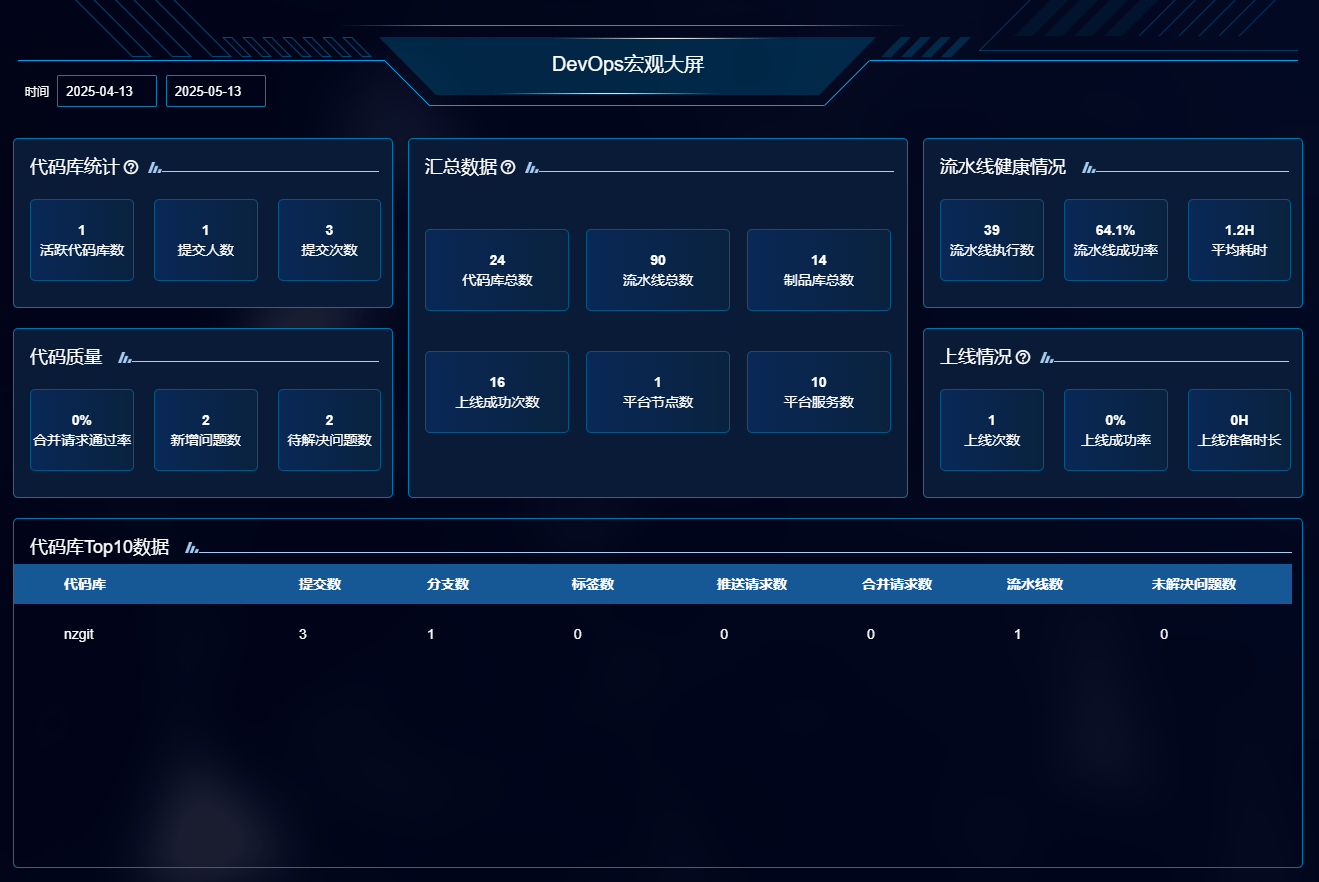 只有基于指标分析去落地改进动作,平衡好交付速度与质量,才能真正发挥DevOps给研发带来的价值。
参考资料:
https://plandek.com/blog/dora-metrics
https://services.google.com/fh/files/misc/2024_final_dora_report.pdf
https://plandek.com/blog/4-pillars-of-software-delivery-productivity
我前段时间拜访客户,有个客户问我:陈哥,我们团队已经用上禅道DevOps平台,流程也算是跑通了,但是怎么来断定到底用得好不好?
我说,DORA指标正好可以解决你这个疑问。
一、什么是DORA指标?
Nicole Forsgren、Jez Humble和Gene Kim在 Accelerate:The Science of Lean Software andDevOps一书中综合阐述了DORA指标。它说明了软件交付绩效与组织成果之间存在着清晰的联系,为管理者提供了了解其交付系统的实际运行情况的方法。DORA指标是五个DevOps性能指标,,主要用于衡量软件交付性能,主要包括:
- 部署频率——你们多久部署一次?
- 变更提前期——从编写代码到最终投入生产需要多长时间?
- 部署失败恢复时间——你们修复故障的速度有多快?
- 变更失败率——部署失败的频率如何?
- 部署返工率——有多少次部署是由事件触发的?
在DORA指标立,前三项衡量了吞吐量,也就是团队工作的完成速度;后两项衡量了稳定性,嗲表了交付的安全性。真正高效的团队,不会单纯为了追求某一项指标,而牺牲另一项。
1. 部署频率
部署频率衡量的是你们团队向生产环境发布代码的频率。实际上,这反映了团队是否能做到小批量上线和高自动化。部署过程越繁琐,团队就越不敢频繁发版,反之亦然。
给大家一个可以参考的基准数:
- 精英团队:每日部署1次以上
- 高性能团队:每周部署1次以上
- 普通团队:每2-4周部署1次以上
变更提前期(也称变更交付周期 )衡量的是已提交的代码到达生产环境所需的时间。这一般与写代码的速度没什么关系,它主要取决于工作在队列中的等待时间,例如pull请求审查或质量保证交接。如果交付周期过长,那就是流程上出现了问题,而不是工作量问题。
给大家一个可以参考的基准数:
- 精英团队:1天之内
- 高性能团队:1周之内
- 普通团队:1个月之内
部署失败恢复时间衡量的是团队在因代码更改导致部署失败后恢复服务的速度。这比通用的平均恢复时间(MTTR)更有用,因为它能隔离我们自身引入的故障。它能更清晰地表明我们的交付系统应对变化的弹性。
给大家一个可以参考的基准数:
- 精英团队:1小时之内
- 高性能团队:1天之内
- 普通团队:1周之内
变更失败率衡量的是部署过程中出现故障,需要立即进行补救(例如回滚或热修复)的占比。
这个指标只有在特定背景下才有意义。如果故障率和部署频率比较低,不一定是质量有多好,可能是在规避风险。健康的交付,是要吞吐量和稳定性两手抓。
给大家一个可以参考的基准数:
- 精英团队:失败率维持在0-15%
- 高性能团队:失败率维持在15-22%
- 普通团队:失败率维持在22-30%
部署返工率衡量的是计划外部署和由生产事故触发的部署的占比。高返工率意味着团队耗费资源修复问题,这是系统性质量或工作流程问题的早期预警信号。
因为部署返工率是新增度量项,目前还没有官方行业基准。
二、如何解读DORA指标?
了解了DORA指标都代表什么,那我们该如何去测量DORA指标呢?- 部署频率:统计CI/CD流水线中成功部署到生产环境的次数;
- 变更提前期:衡量从提交到生产环境的时间;
- 部署失败恢复时间:从事件发生到服务恢复所需的时间;
- 变更失败率:与事件、回滚或热修复相关的部署百分比;
- 部署返工率:由突发事件而非计划工作触发的部署百分比。
三、如何看懂DORA指标?
DORA指标最大价值,是给软件交付能力提供清晰参照标准,比如我们能不能快速交付产品、出问题之后能不能快速恢复。但DORA指标也有局限,就是它只能告诉我们发生了什么,不能告诉我们为什么会发生。举个例子,如果交付周期边长,原因可能是代码审查缓慢,也可能是质量问题,具体原因我们没办法通过指标看出来的。
所以,我们要思考的问题从来都不是DORA指标有没有变得更好,而是:
- 我们到底是在加快进度,还是在制造更多的返工?
- 我们是在提高发布频率,还是在分割错误的工作?
- 故障率下降是因为质量提高,还是因为部署速度减慢?
- 人工智能是在改善交付,还是仅仅增加了上游活动?
正是因为DORA指标存在这类短板,普兰德克提出的工程生产力四大支柱就可以发挥作用。把DORA指标和工程生产力四大支柱搭配使用,才能使DORA真正发挥作用。
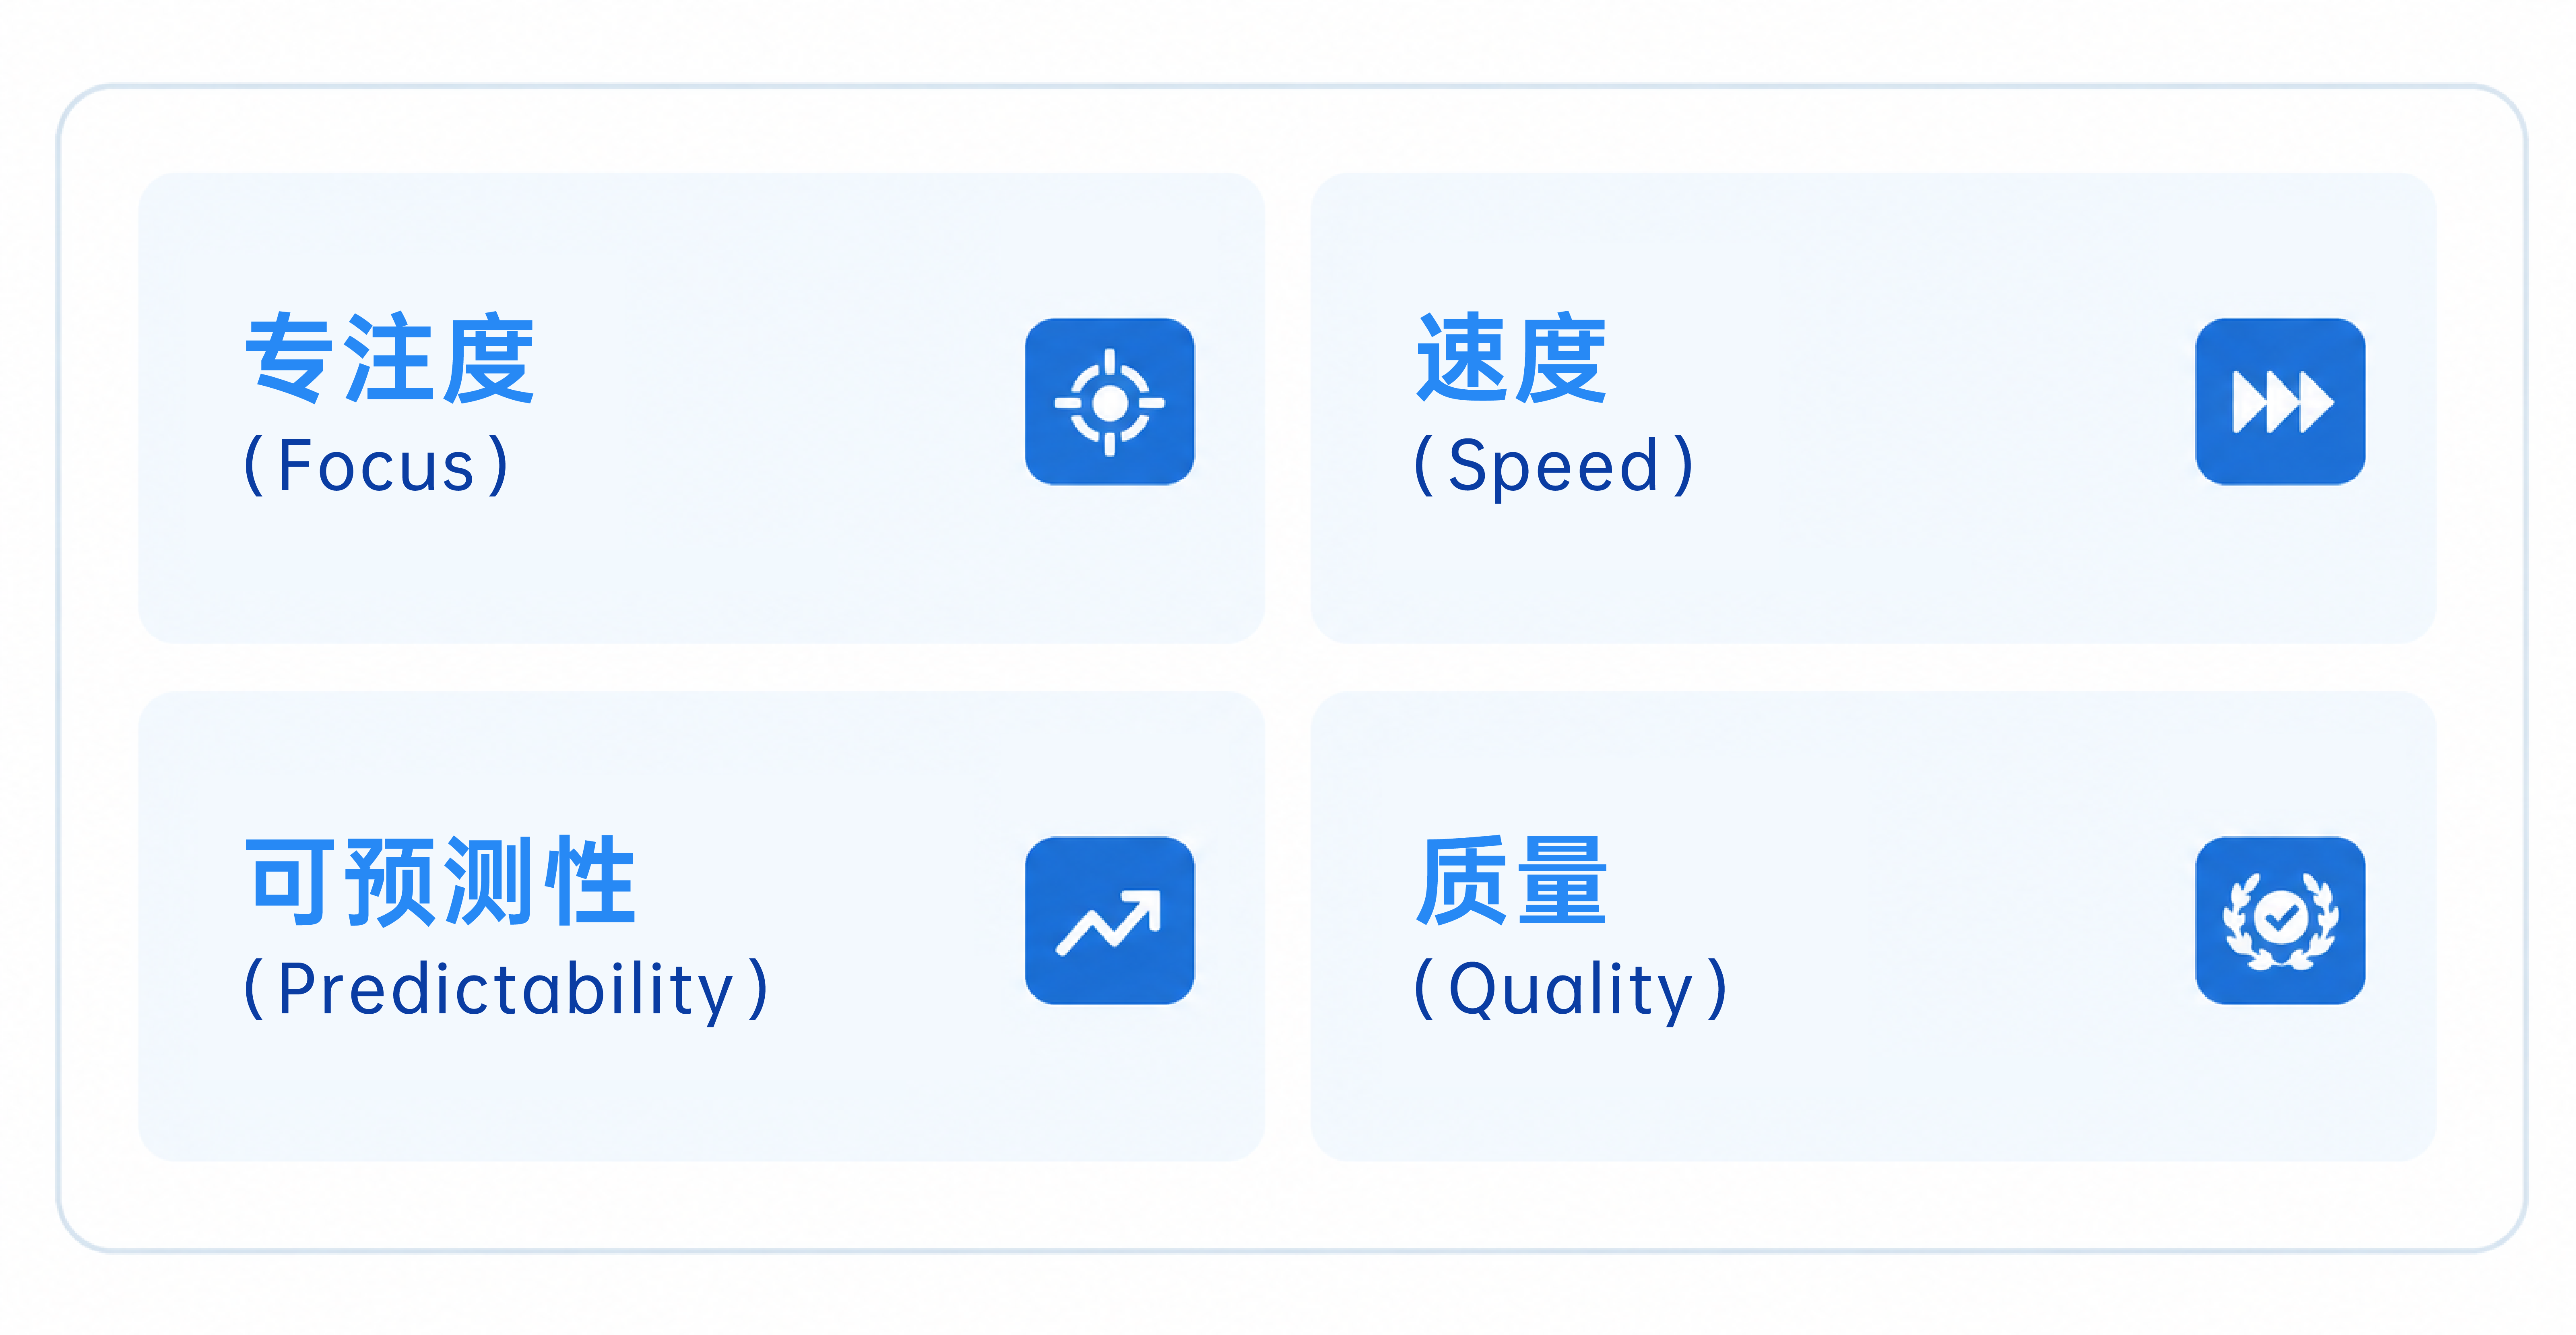
工程生产力四大支柱把DORA指标转化为4个表观这需要思考的问题,让DORA指标更加直观。
- 专注度(Focus):我们是否在做正确的事情? 团队有多少工程能力用于创造业务价值,而不是消耗在运维支持、返工、维护旧系统上?
- 速度(Speed):我们的交付效率如何? 从需求构思到上线生产,整体流转速度怎么样?团队付出的人力,转化成业务成果的效率怎么样?
- 可预测性(Predictability):我们交付的稳定性怎么样? 团队能不能可靠规划并落地工作计划,尽量减少大范围波动与突发中断?
- 质量(Quality):我们能否可持续输出高质量成果? 产能提升,带来持久业务价值,还是带来大量缺陷、返工,透支团队后续研发能力?
四、写在最后
回到文章最开始客户提出的问题,DORA 指标就是一把很好的度量标尺,但我们不能把它简单当作硬性考核目标。借助禅道DevOps平台,我们可以统计分析出DORA指标,看清团队交付的吞吐量与稳定性。但数据只是表象,不能孤立看待数字高低,更要结合指标组合模式。
参考资料:
https://plandek.com/blog/dora-metrics
https://services.google.com/fh/files/misc/2024_final_dora_report.pdf
https://plandek.com/blog/4-pillars-of-software-delivery-productivity

推荐阅读

这款自研底层框架,你说不定已经用上了
“国产替代不是简单的替换产品,而是要构建起一个从底层技术到顶层解决方案完全自主可控的产业链。这不仅是一场技术较量,更是一场民族工业崛起的马拉松。”
2025-04-17
测试开发之前端篇-CSS层叠式样式表
CSS是层叠样式表(Cascading Style Sheets)的缩写,用于描述如何在屏幕、纸张或其他媒体上显示HTML元素,包括了定义网页及其元素的布局、风格、大小、位置和颜色等属性。 CSS的语法表示为: 以下是一个简单的例子,设置了网页主体(body)的背景色、标题(h1)的颜色和对齐方式、段落(p)的字体和大小。 body { background-color: lightb...
 aaronchen2k 2021-09-03
联系我们
杨苗
高级客户经理
电话(微信)
13165050229
QQ号码
2692096539
联系邮箱
yangmiao@chandao.com
联系我们
李木
高级客户经理
电话(微信)
18562583552
QQ号码
3985895121
联系邮箱
limu@chandao.com
!您的禅道专属服务通道已开启
感谢您的!为确保您能充分发挥禅道的价值,我们为您准备了以下专属服务:
 精品资料包
立即获取《软件研发质量管理体系建设白皮书》、《PMO实践白皮书》《IPD资料》等行业最佳实践资料。
 1V1产品演示
为您量身定制线上演示,深度讲解核心功能与适用场景。
 免费试用增强功能
获取正式试用授权,解锁全部功能,带领团队亲身体验。
 专属顾问答疑支持
在使用中遇到的任何问题,您的专属顾问将及时为您解答。
添加您的专属顾问获取服务
扫码添加领专属服务